 AI学部の解説
ハルシネーションとは?
なんでAIは、しれっと嘘をつくの?
AIがもっともらしい嘘をつく理由を、入力CHUの3人が会話で解説。出やすい場面と、防ぐ3つのコツまで。
 社会人部の時事解説
フランスのデモ、なんで起きた?
時事漫才ヨミカケ #01 の出典と事実
2026年10月17日のフランス全土のデモ。きっかけは高校の先生不足、そこに燃料の値上がりの怒りが合流。動画で使った事実と出典の一覧。
 社会人部の時事解説
アジアカップが危ない?サウジを揺さぶるフーシ派
時事漫才ヨミカケ #02 の出典と事実
アジアカップの開催国サウジへの、イエメンのフーシ派の攻撃。止まっていた戦争の再開・兵器を自分で作れるように・サウジの守りが手薄に。動画で使った事実と出典の一覧。
 社会人部の時事解説
日本のGDP、なぜ6位へ?
時事漫才ヨミカケ #03 の出典と事実
IMFの予測で、日本の名目GDPは2027年にインド・イギリスに抜かれ6位へ。円安でドル換算が目減り・30年の伸びがゆっくり・人口減の3つ。動画で使った事実と出典の一覧。
 社会人部の時事解説
PHPの緊急脆弱性、みんな何をしてる?
時事漫才ヨミカケ #04 の出典と事実
PHP開発チームが修正版を出した重大な脆弱性2件(認証なしで外からコードを実行されうる)と、各社・各機関の対応、過去の事例、「安全な言語」の考え方。動画で使った事実と出典の一覧。
 入力CHUのG検定 第1章
人工知能(AI)の定義
AIって、結局なんなの?
AIの定義は研究者ごとにちがう? 名前が生まれた1956年のダートマス会議、AIとロボットのちがい、「AI効果」とエージェントまで、入力CHUの3人が会話で解説。
- 入力CHUのG検定 第1章
人工知能の4つのレベル
「AI搭載」のエアコンって、本当にAIなの?
AIは「単純な制御プログラム」「古典的な人工知能」「機械学習」「ディープラーニング」の4つのレベルで見分けられる。ルールを人が書くのか、データから学ぶのか、特徴量まで学ぶのか。入力CHUの3人が会話で解説。
- 入力CHUのG検定 第1章
強いAIと弱いAI
ドラえもんは「強いAI」なの?
「強いAI・弱いAI」は強さではなく「心や理解を持つか」の区別で、1980年に哲学者サールが言い出した。「何でもこなせるか」を表す汎用AI・特化型AIとのちがい、今のAIの立ち位置まで、入力CHUの3人が会話で解説。
- 入力CHUのG検定 第1章
シンギュラリティ(技術的特異点)
AIが人間を超える日って、本当に来るの?
シンギュラリティ(技術的特異点)とは何か。グッドの「知能の爆発」、1993年のヴィンジの論文、カーツワイルの「2045年」予測まで。来るかどうかは分からない「予測」として覚えるコツを、入力CHUの3人が会話で解説。
- 入力CHUのG検定 第1章
人工知能分野で議論される問題
AIは本当に「分かって」いるの?
フレーム問題(1969年)、シンボルグラウンディング問題(1990年)、チューリングテスト(1950年)、中国語の部屋(1980年)。AIの「理解」をめぐる4つの有名な問題を、誰がいつ言い出したかとあわせて入力CHUの3人が会話で解説。
- 入力CHUのG検定 第2章
第1次AIブーム(推論・探索の時代)
最初のAIブームは、なぜ終わったの?
1950年代後半〜1960年代の第1次AIブームは「推論」と「探索」の時代。探索木で迷路やパズルは解けたが、現実の問題は選択肢が多すぎて解けず「トイ・プロブレム」と批判され冬の時代へ。入力CHUの3人が会話で解説。
- 入力CHUのG検定 第2章
第2次AIブームとエキスパートシステム
専門家の知識を詰めこんだAIは、なぜ行きづまったの?
1980年代の第2次AIブームは「知識」の時代。専門家の知識をルールにしたエキスパートシステム、マイシン(MYCIN)とDENDRAL、そして知識をルールに書く手間が壁になった「知識獲得のボトルネック」まで、入力CHUの3人が会話で解説。
- 入力CHUのG検定 第2章
探索アルゴリズム(幅優先探索と深さ優先探索)
迷路の解き方にも、性格があるの?
探索の基本、幅優先探索と深さ優先探索のちがい。幅優先は最も浅い(手数の少ない)答えを必ず見つけるがメモリを食い、深さ優先はメモリが少なくてすむが最短とは限らない。ブルートフォースやハノイの塔まで、入力CHUの3人が会話で解説。
- 入力CHUのG検定 第2章
知識表現(意味ネットワークとオントロジー)
コンピュータに「常識」を教えるには?
人の知識をコンピュータが扱える形に書く「知識表現」。概念を矢印でつなぐ意味ネットワーク(is-a・part-of の関係)、オントロジー、常識を全部書こうとしたCycプロジェクト、今の検索を支えるナレッジグラフまで、入力CHUの3人が会話で解説。
- 入力CHUのG検定 第2章
機械学習と第3次AIブーム
ルールを書かずに、データから学ぶってどういうこと?
2000年代からの第3次AIブームは機械学習の時代。ビッグデータと計算力の向上がきっかけになった理由、スパムフィルタやレコメンデーションエンジンという代表例、特徴が増えるほど学びにくくなる「次元の呪い」まで、入力CHUの3人が会話で解説。
- 入力CHUのG検定 第2章
ディープラーニングの登場
2012年、AIの世界で何が起きたの?
2012年の画像認識コンテストILSVRCで、ディープラーニングが2位に大差をつけて優勝。ただし人間を超えたのは2015年。源流のネオコグニトロンとLeNet、ImageNet・GPUがそろった理由、アルファ碁まで、入力CHUの3人が会話で解説。
- 入力CHUのG検定 第3章
機械学習の3つのタイプ
教師あり・教師なし・強化学習、何がちがうの?
機械学習は「教師あり学習」「教師なし学習」「強化学習」の3つに分けられる。何を手がかりに学ぶのか(正解ラベル・特徴量だけ・報酬)のちがいと、使い分けの考え方を、入力CHUの3人が会話で解説。
- 入力CHUのG検定 第3章
回帰問題と線形回帰
家賃みたいな「数値」は、どうやって予測するの?
教師あり学習で連続した数値を予測する「回帰問題」。データにいちばん合う直線を引く線形回帰、説明に使う変数が1つの単回帰分析と複数の重回帰分析、過去の自分から予測するARモデル・VARモデルまでを会話で解説。
- 入力CHUのG検定 第3章
回帰モデルの評価指標(MAE・MSE・RMSE)
予測の「ズレ」は、どうやって測るの?
回帰モデルの予測がどれだけ外れたかを測る3つの指標、平均絶対値誤差(MAE)・平均二乗誤差(MSE)・二乗平均平方根誤差(RMSE)。式のちがい、大きな外れへの厳しさ、単位のちがいを、具体的な数字で計算しながら会話で解説。
- 入力CHUのG検定 第3章
分類問題(ロジスティック回帰とSVM)
迷惑メールかどうか、AIはどうやって仕分けてるの?
教師あり学習でデータをグループ(クラス)に仕分ける「分類問題」。名前は回帰でも分類に使うロジスティック回帰、境界線とデータのすき間を最大にするSVMのマージン最大化、曲がった境界を引くカーネルトリックまでを会話で解説。
- 入力CHUのG検定 第3章
決定木
「もし〜なら」をくり返すだけで、AIになるの?
「はい/いいえ」の質問をくり返してデータを分けていく決定木。分け方を決める不純度(ジニ不純度・エントロピー)、判断の理由が説明しやすいという長所、過学習しやすく不安定という弱点、そしてアンサンブル学習につながる理由を会話で解説。
- 入力CHUのG検定 第3章
アンサンブル学習(バギングとブースティング)
モデルを何個も集めると、なぜ強くなるの?
複数のモデルを組み合わせて1つの予測を出すアンサンブル学習。ブートストラップサンプリングで並列に学ぶバギングとランダムフォレスト、前のモデルの間違いを順番に直していくブースティングと勾配ブースティングのちがいを会話で解説。
- 入力CHUのG検定 第3章
クラスタリング(k-means法と階層的クラスタリング)
正解がないのに、どうやってグループ分けするの?
教師なし学習の代表、クラスタリング。先にグループ数kを決めて中心を動かしていくk-means法の手順と注意点、似たものから順にまとめていく階層的クラスタリング、ウォード法、デンドログラム(樹形図)の読み方を会話で解説。
- 入力CHUのG検定 第3章
次元削減(主成分分析とt-SNE)
項目が多すぎるデータは、どうやってシンプルにするの?
たくさんの特徴量を、情報をなるべく残したまま少ない数にまとめる次元削減。ばらつきが最大の方向を探す主成分分析(PCA)と寄与率、高次元で起きる「次元の呪い」、2〜3次元の地図に描いて見るためのt-SNEまでを会話で解説。
- 入力CHUのG検定 第3章
レコメンデーション(推薦システム)
「あなたへのおすすめ」って、どうやって選んでるの?
通販や動画サービスの「おすすめ」のしくみを解説。協調フィルタリングとコンテンツベースフィルタリングのちがい、コールドスタート問題、両方を組み合わせるハイブリッドまで、入力CHUの3人が会話で整理。
- 入力CHUのG検定 第3章
強化学習
正解を教えないのに、どうやって賢くなるの?
強化学習のしくみを解説。エージェント・環境・状態・行動・報酬・方策の関係、割引率、行動価値(Q値)を学ぶQ学習、探索と活用のε-greedy方策、AlphaGo Zeroの例まで、入力CHUの3人が会話で整理。
- 入力CHUのG検定 第3章
強化学習の代表的な手法(SARSA・方策勾配法・MARL)
Q学習とSARSA、なにがちがうの?
強化学習の手法を整理。方策オフ型のQ学習と方策オン型のSARSAのちがい(崖歩きの例)、価値を学ぶ方法と方策を直接学ぶ方策勾配法・REINFORCE・Actor-Critic、複数のエージェントが学ぶマルチエージェント強化学習まで会話で解説。
- 入力CHUのG検定 第3章
モデルの評価指標(混同行列・適合率・再現率・F値)
正解率99%なのに「使えない」ってどういうこと?
分類モデルの成績表の読み方を解説。混同行列(真陽性・偽陽性・偽陰性・真陰性)から、正解率・適合率・再現率・F値の式と使い分け、トレードオフ、回帰で使うMSE・RMSE・MAEまで、入力CHUの3人が会話で整理。
- 入力CHUのG検定 第3章
ROC曲線とAUC
しきい値を変えると成績が変わる…じゃあ何で比べるの?
分類モデルの「しきい値」を動かしたときの成績を1本の線で見るROC曲線と、その下の面積AUCを解説。縦軸の真陽性率・横軸の偽陽性率の式、左上ほど良い理由、AUC=0.5と1.0の意味まで会話で整理。
- 入力CHUのG検定 第3章
過学習と汎化性能
練習では満点なのに、本番でボロボロ…なんで?
訓練データに合わせすぎて新しいデータで外れる「過学習」を解説。訓練誤差と汎化誤差のちがい、原因、見つけ方、正則化・早期終了などの対策、オッカムの剃刀とAIC・BICによるモデル選択まで、入力CHUの3人が会話で整理。
- 入力CHUのG検定 第3章
交差検証とホールドアウト検証
手持ちのデータだけで、本番の実力ってどう測るの?
モデルの汎化性能を見積もる検証方法を解説。データを訓練用・検証用・テスト用に分けるホールドアウト検証、全データを順番に検証に使うk-分割交差検証の手順と長所・短所、一つ抜き交差検証や時系列データの注意点まで会話で整理。
- 入力CHUのG検定 第4章
ニューラルネットワークとディープラーニング
パーセプトロンを重ねると、なぜディープラーニングになるの?
単純パーセプトロンと多層パーセプトロンのちがい、入力層・隠れ層・出力層、隠れ層を深くしたのがディープラーニングという関係、学習にGPUやTPUが使われる理由まで、入力CHUの3人が会話で解説。
- 入力CHUのG検定 第4章
活性化関数
シグモイド、ReLU、ソフトマックス…どう使い分けるの?
活性化関数がないと層を重ねても意味がない理由、シグモイド・tanh・ReLU・Leaky ReLU・ソフトマックスの形と使い分け、シグモイドで起きやすい勾配消失問題まで、入力CHUの3人が会話で解説。
- 入力CHUのG検定 第4章
誤差関数(損失関数)
AIの「まちがい度」は、どうやって測るの?
回帰で使う平均二乗誤差、分類で使う交差エントロピー、確率分布のずれを測るKLダイバージェンス、似ているものを近づけるContrastive LossとTriplet Lossまで、タスクごとの誤差関数の選び方を入力CHUの3人が会話で解説。
- 入力CHUのG検定 第4章
勾配降下法
AIは、どうやって誤差を小さくしていくの?
誤差の坂を下る勾配降下法のしくみと式、学習率の決め方、局所最適解・大域最適解・鞍点という落とし穴、バッチ学習・ミニバッチ学習・オンライン学習とエポック・イテレーションのちがいまで、入力CHUの3人が会話で解説。
- 入力CHUのG検定 第4章
最適化手法(モーメンタム・AdaGrad・RMSprop・Adam)
ふつうの勾配降下法の、なにを改良したの?
勢いをつけるモーメンタム、重みごとに歩はばを変えるAdaGradとRMSprop、両方を合わせたAdam、その後のAdaDelta・AdaBound・AMSBound、「どんな問題でも最強の手法はない」というノーフリーランチの定理まで、入力CHUの3人が会話で解説。
- 入力CHUのG検定 第4章
誤差逆伝播法
まちがいの責任を、どうやって各層に割りふるの?
どの重みがまちがいの原因かという信用割当問題、それを連鎖律で出力側から逆向きに解く誤差逆伝播法、深い層で起きる勾配消失問題と勾配爆発問題、その原因と対策まで、入力CHUの3人が会話で解説。
- 入力CHUのG検定 第4章
正則化(L1・L2・ドロップアウト)
過学習を防ぐために、わざと「ブレーキ」をかけるって本当?
正則化の目的、誤差に重みの大きさのペナルティを足すしくみ、L1正則化(ラッソ回帰)・L2正則化(リッジ回帰)・L0正則化のちがいと使い分け、学習中にニューロンをランダムに休ませるドロップアウトまで、入力CHUの3人が会話で解説。
- 入力CHUのG検定 第4章
ハイパーパラメータの調整
AIが自分で決められない設定は、どうやって選ぶの?
学習で決まるパラメータと人が決めるハイパーパラメータのちがい、グリッドサーチ・ランダムサーチ・ベイズ最適化による探し方、学習を途中で止める早期終了、学習を続けると一度悪くなってまた良くなる二重降下現象まで、入力CHUの3人が会話で解説。
- 入力CHUのG検定 第5章
畳み込み層(CNN)
画像認識で使う「畳み込み」って、なにをしてるの?
フィルタ(カーネル)を画像の上ですべらせて特徴マップを作る畳み込み層のしくみを、入力CHUの3人が会話で解説。全結合層とのパラメータ数のちがい、ストライド・パディングの計算、Dilated・Depthwise Separable Convolutionまで。
- 入力CHUのG検定 第5章
プーリング層
特徴マップを小さくまとめるって、どういうこと?
特徴マップを小さな区画に分けて代表の値を選ぶプーリング層を、入力CHUの3人が会話で解説。最大値プーリングと平均値プーリングのちがい、少しのずれに強くなる「不変性の獲得」、全結合層の代わりに使うグローバルアベレージプーリング(GAP)まで。
- 入力CHUのG検定 第5章
スキップ結合(ResNet)
層を飛ばして足すだけで、なぜ深くできるの?
入力を数層ぶん飛ばして出力に足し合わせる「スキップ結合」と、それを使った2015年のResNetを、入力CHUの3人が会話で解説。深くすると精度が下がる問題、残差学習 y=F(x)+x の意味、152層とILSVRC 2015での1位まで。
- 入力CHUのG検定 第5章
正規化層
バッチ正規化・レイヤー正規化、何をそろえてるの?
層の出力を平均0・分散1にそろえて学習を安定させる正規化層を、入力CHUの3人が会話で解説。2015年のバッチ正規化と「内部共変量シフト」をめぐる議論、レイヤー正規化・インスタンス正規化・グループ正規化のちがい(どこで平均をとるか)まで。
- 入力CHUのG検定 第5章
回帰結合層(RNN)
前の時刻を覚えているネットワークって、どういうしくみ?
隠れ層の出力を次の時刻に戻す「回帰結合層」と、それを持つRNNを、入力CHUの3人が会話で解説。時系列データ、エルマンネットワークとジョルダンネットワークのちがい、時間方向に展開して学ぶBPTT、教師強制、双方向RNNまで。
- 入力CHUのG検定 第5章
LSTMとGRU
RNNの「忘れっぽさ」を、ゲートでどう直したの?
RNNが長い系列で苦手な勾配消失問題・勾配爆発問題と、それをゲート機構で和らげたLSTM(1997年)とGRU(2014年)を、入力CHUの3人が会話で解説。忘却・入力・出力ゲートの役わり、忘却ゲートは後から加わったこと、GRUの2つのゲートまで。
- 入力CHUのG検定 第5章
AttentionとTransformer
「どこに注目するか」を、AIはどうやって決めてるの?
入力のどこに注目するかを重みで決めるAttentionと、2017年のTransformerを入力CHUの3人が会話で解説。Seq2Seqの弱点、クエリ・キー・バリュー、Self-AttentionとSource-Target Attention、位置エンコーディングまで。
- 入力CHUのG検定 第5章
オートエンコーダ
入力をそのまま出すだけのネットワークが、なぜ役に立つの?
入力をいったん小さく圧縮してから元に戻すように学ぶオートエンコーダを、入力CHUの3人が会話で解説。エンコーダとデコーダ、次元削減、積層オートエンコーダと事前学習、変分オートエンコーダ(VAE)と、β-VAE・VQ-VAE・InfoVAEまで。
- 入力CHUのG検定 第5章
データ拡張
学習データを「水増し」して、なぜ賢くなるの?
手持ちのデータを少しずつ変えて増やすデータ拡張を入力CHUの3人が会話で解説。反転・回転などの基本、CutoutとRandom Erasing、MixupとCutMixのちがい、RandAugment、文章や音声での拡張と注意点まで。
- 入力CHUのG検定 第6章
画像認識のタスク
物体検出とセグメンテーション、何がちがうの?
画像認識には「何が写っているか」を当てる物体識別から、位置を四角で示す物体検出、画素ごとに塗り分けるセグメンテーション、関節を見つける姿勢推定まである。代表モデルYOLO・Mask R-CNN・U-Net・OpenPoseも会話で解説。
- 入力CHUのG検定 第6章
代表的な画像認識モデル
AlexNetからVision Transformerまで、何が進化したの?
2012年のAlexNetから、VGG・GoogLeNet・ResNet、軽量なMobileNet、自動設計のNAS・EfficientNet、2020年のVision Transformerまで。ILSVRCでの成績と各モデルの工夫を、入力CHUの3人が会話で解説。
- 入力CHUのG検定 第6章
統計的機械翻訳
ニューラルネット以前の翻訳AIは、どうやって訳していたの?
大量の対訳データから「どう訳されやすいか」を確率で学ぶ統計的機械翻訳。翻訳モデルと言語モデル(n-gram)の役わり、ルールベースからニューラル機械翻訳(Seq2Seq)への流れ、Google翻訳の切りかえまで会話で解説。
- 入力CHUのG検定 第6章
自然言語処理と単語埋め込み
コンピュータは、言葉をどうやって数字にしているの?
自然言語処理のタスク(機械翻訳・感情分析・質問応答など)と、形態素解析・構文解析、言葉を数字にする方法をまとめて解説。ワンホットベクトル、BoW、TF-IDFから、分散表現のword2vec・fastText・ELMoまで。
- 入力CHUのG検定 第6章
Transformerと大規模言語モデル
BERTとGPT、どっちもTransformerなのに何がちがうの?
2017年のTransformerは、RNNを使わずAttentionだけで文を読む。そこから生まれた「穴埋め」のBERTと「続き予測」のGPT、評価に使うGLUE、パラメータ数5400億のPaLMなど大規模言語モデル(LLM)まで会話で解説。
- 入力CHUのG検定 第6章
音声処理
AIは、声をどうやって聞いて、どうやって話すの?
声をデジタルにするA-D変換・PCM、高速フーリエ変換で周波数を見ること、フォルマントやメル尺度、音声認識の特徴量MFCC、隠れマルコフモデルとCTC、音声合成のWaveNet、話者識別まで。音声処理のキーワードを会話で解説。
- 入力CHUのG検定 第6章
深層強化学習
AIがゲームや囲碁で人間に勝てたのはなぜ?
強化学習とディープラーニングを合わせた「深層強化学習」を解説。DQN(2013・2015年)、AlphaGo(2016年)とAlphaGo Zero、ダブルDQNなどの改良、sim2real、人間の好みで学ぶRLHFまで、入力CHUの3人が会話で整理。
- 入力CHUのG検定 第6章
データ生成(GAN・拡散モデル)
AIはどうやって、ない画像を作るの?
本物そっくりのデータを作るデータ生成を解説。生成器と識別器が競うGAN(2014年)、DCGAN・Pix2Pix・CycleGAN、ノイズを消して画像を作る拡散モデル、写真から3D空間を作るNeRFまで、入力CHUの3人が会話で整理。
- 入力CHUのG検定 第6章
転移学習・ファインチューニング
賢いAIの「学んだこと」を、別の仕事に使い回せるの?
事前学習済みモデルを別のタスクに使い回す転移学習とファインチューニングを解説。2つのちがい、自己教師あり学習・半教師あり学習、Few-shot・One-shot、BERTの例、そして新しいことを学ぶと前を忘れる「破滅的忘却」まで、入力CHUの3人が会話で整理。
- 入力CHUのG検定 第6章
マルチモーダル
画像も言葉もいっしょに分かるAIって、どうなってるの?
画像・言葉・音声など、種類のちがう情報をまとめて扱うマルチモーダルAIを解説。画像と文章を同じ空間に並べるCLIP、文章から画像を作るDALL-E、Flamingo・Unified-IO、Zero-shot・基盤モデル・VQAまで、入力CHUの3人が会話で整理。
- 入力CHUのG検定 第6章
モデルの解釈性(説明可能AI)
AIがなぜそう判断したのか、のぞけるの?
AIの判断の理由を人が分かる形で示す説明可能AI(XAI)を解説。なぜ必要か、どんな場面で求められるか、LIME・SHAP・Permutation Importance・CAM・Grad-CAMのしくみと使い分けまで、入力CHUの3人が会話で整理。
- 入力CHUのG検定 第6章
モデルの軽量化
大きなAIを、スマホで動かすにはどうするの?
大きなモデルを小さく速くするモデル圧縮を解説。なぜ必要か(エッジAI)、いらない結合をけずるプルーニング、数字を粗くする量子化、先生モデルから学ぶ蒸留、そして「宝くじ仮説」まで、入力CHUの3人が会話で整理。
- 入力CHUのG検定 第7章
AIプロジェクトの進め方
AIを仕事で使うとき、何から始めればいいの?
AIプロジェクトの全体像を解説。データ分析の標準プロセスCRISP-DMの6フェーズ、機械学習向けのCRISP-ML、経産省ガイドラインの「探索的段階型」(アセスメント・PoC・開発・追加学習)、ウォーターフォールとアジャイルまで、入力CHUの3人が会話で整理。
- 入力CHUのG検定 第7章
データの収集・加工・分析・学習
AIに食べさせるデータ、どう集めてどう整えるの?
AIの性能を左右する学習用データの集め方・整え方を解説。オープンデータセットとコーパス、正解をつけるアノテーション、評価を甘くするデータリーケージ、ほかの会社とデータを共有するときの契約の型まで、入力CHUの3人が会話で整理。
- 入力CHUのG検定 第7章
AIの運用とMLOps
AIは作ったら終わり、じゃないの?
AIを世に出したあとの運用を解説。時間とともに性能が落ちる理由(データの変化)、MLOpsとCI/CD/CT、ヘルスモニタリング、Docker・Web API・クラウド・Jupyter Notebookなどの道具、隠れた技術的負債まで、入力CHUの3人が会話で整理。
- 入力CHUのG検定 第8章
個人情報保護法
顔写真もメアドも、ぜんぶ個人情報なの?
個人情報・個人識別符号・要配慮個人情報・個人データのちがい、利用目的と第三者提供のルール、委託の扱い、2026年7月に公布された改正のポイントまで、入力CHUの3人が会話で解説。
- 入力CHUのG検定 第8章
仮名加工情報・匿名加工情報とGDPR
個人情報を、安全にAIに使う方法ってあるの?
仮名加工情報と匿名加工情報は何がちがう? 照合の禁止、第三者提供できる・できない、利用目的の変更、そしてEU域外の会社にも及ぶGDPRと日EUの十分性認定まで、入力CHUの3人が会話で解説。
- 入力CHUのG検定 第8章
著作権法とAI(学習・生成・AI生成物)
AIの学習って、人の作品を勝手に使っていいの?
著作権法30条の4で学習はどこまでOK? 「享受目的」とただし書、生成物の著作権侵害を決める「類似性と依拠性」、AI生成物が著作物になる「創作的寄与」まで、文化庁の考え方(2024年3月)をもとに入力CHUの3人が会話で解説。
- 入力CHUのG検定 第8章
特許法と不正競争防止法(営業秘密・限定提供データ)
AIの技術は、公開して守る? 隠して守る?
発明・新規性・進歩性・職務発明、特許権と著作権のすみ分け、AIは発明者になれるか(2026年3月に最高裁で確定)、営業秘密の3要件と限定提供データまで、入力CHUの3人が会話で解説。
- 入力CHUのG検定 第8章
独占禁止法とAI開発契約
AIで値段を合わせたらカルテル? 開発の契約はどう結ぶ?
アルゴリズムによる価格の協調や生成AI市場の囲い込みは独占禁止法でどう見る? 経産省の契約ガイドラインが提唱する「探索的段階型」、請負と準委任、NDA・精度保証・知的財産の帰属、SaaSの利用規約まで、入力CHUの3人が会話で解説。
- 入力CHUのG検定 第8章
AI倫理・AIガバナンスと国内外のガイドライン
法律で決まってなくても、守るべきことってある?
AI倫理とAIガバナンスのちがい、ハードローとソフトロー、リスクベースアプローチ、AI事業者ガイドライン(2026年3月 第1.2版)の10の共通指針、2025年施行のAI推進法とEUのAI法まで、入力CHUの3人が会話で解説。
- 入力CHUのG検定 第8章
AIの公平性
AIは感情がないのに、なぜ差別しちゃうの?
AIが不公平な判断をするのはなぜ? データの偏り・サンプリングバイアス・代理変数という原因、採用AI・再犯予測・顔分析の有名な事例、「公平性の定義」が1つに決まらない理由と対策まで、入力CHUの3人が会話で解説。
- 入力CHUのG検定 第8章
AIの安全性とセキュリティ
AIって、だまされたり盗まれたりするの?
パンダをテナガザルと言わせる敵対的サンプル、シールで停止標識を誤認させる実験、データ汚染・モデル汚染・モデル窃取・データ窃取のちがい、守り方のセキュリティ・バイ・デザインと国のガイドラインまで、入力CHUの3人が会話で解説。
- 入力CHUのG検定 第8章
AIとプライバシー
AIは、わたしのことをどこまで推測できちゃうの?
データを集めるときと、AIが推測するときのプライバシー問題のちがい、内定辞退率を予測したリクナビ事件、カメラ画像利活用ガイドブック、プライバシー・バイ・デザインと差分プライバシーまで、入力CHUの3人が会話で解説。
- 入力CHUのG検定 第8章
AI技術の悪用(ディープフェイクとフェイクニュース)
その動画、本物? AIの悪用ってどんなこと?
偽のビデオ会議で約2,500万ドルをだまし取られたディープフェイク事件、株価が一時下がった偽画像、エコーチェンバーとフィルターバブル、来歴の技術や法律・リテラシーによる対策まで、入力CHUの3人が会話で解説。
- 入力CHUのG検定 第8章
AIの透明性と説明可能性
AIは、なぜその答えにしたのか説明できるの?
ディープラーニングがブラックボックスになりやすい理由、透明性と説明可能性のちがい、融資や医療で説明が求められる根拠、LIME・SHAP・Grad-CAMなどのXAI、データの来歴まで、入力CHUの3人が会話で解説。
- 入力CHUのG検定 第8章
環境保護・労働政策・その他の重要な価値
AIの電気代、仕事、亡くなった人の再現…ほかにどんな論点があるの?
モデル学習の電力消費と気候変動、AIとの協働・スキルの喪失・労働力不足、インクルージョン、軍事利用、死者への敬意、人間の自律性まで。AI倫理の残りの論点を、人間中心のAI社会原則とあわせて入力CHUの3人が会話で解説。
- 入力CHUのG検定 第8章
AIガバナンスの実践
AI倫理を、会社の中でどうやって実行するの?
AIポリシーと倫理アセスメント、人間の関与、ダイバーシティ、トレーサビリティ・再現性・モニタリング・監査、そして回し続けるアジャイル・ガバナンスまで。2026年10月時点の国の枠組みもあわせて、入力CHUの3人が会話で解説。
- 入力CHUのG検定 第9章
代表値(平均値・中央値・最頻値)と外れ値
平均だけ見てると、だまされるって本当?
クラス会の平均年収はなぜ高すぎる? 平均値・中央値・最頻値の求め方とちがい、外れ値に強いのはどれか、偶数個のときの中央値、度数分布表から最頻値を読む方法、AIの前処理での使い方まで、入力CHUの3人が会話で解説。
- 入力CHUのG検定 第9章
分散と標準偏差
平均点が同じでも、ちがうクラスってどういうこと?
平均点が同じなのに中身がちがう2つのクラスを例に、偏差・分散・標準偏差の求め方と意味、なぜ2乗してから平方根をとるのか、偏差値の計算、AIの前処理で使う標準化まで、入力CHUの3人が会話で解説。
- 入力CHUのG検定 第9章
確率分布(正規分布・二項分布・ポアソン分布)
サイコロ、コイン、身長…データの「出かた」にパターンはあるの?
確率変数と確率分布、期待値の考え方から、正規分布の68%・95%・99.7%、ベルヌーイ分布と二項分布の式、まれな出来事の回数を表すポアソン分布、分類AIの出力が確率分布になる話まで、入力CHUの3人が会話で解説。
- 入力CHUのG検定 第9章
相関係数と疑似相関(相関と因果)
アイスが売れると水の事故が増える…犯人はアイス?
相関係数の意味と求め方(共分散÷標準偏差の積)、正の相関・負の相関、相関係数0でも関係がある場合、隠れた第三の変数が生む疑似相関、偏相関係数、因果関係を確かめる実験まで、名探偵シオンと入力CHUの3人が会話で解説。
- 入力CHUのG検定 第9章
微分と勾配降下法(最適化の数学)
AIは、どうやって「まちがい」を減らしているの?
スピードメーターでわかる微分(瞬間の変化率・接線の傾き)、x²の微分、たくさんの値があるときの偏微分と勾配、誤差の坂道を下る勾配降下法と学習率、局所最適解の落とし穴まで、入力CHUの3人が数値つきの会話で解説。
- 入力CHUのG検定 番外編
G検定の基本情報(試験時間・問題数・受験料・日程)
G検定って、いつ・どこで・何問の試験なの?
G検定(ジェネラリスト検定)の基本を2026年10月時点の公式情報で整理。主催のJDLA、オンライン100分・会場120分で145問程度、受験料、2026年の日程、合格率、出題範囲(シラバス)まで会話で解説。
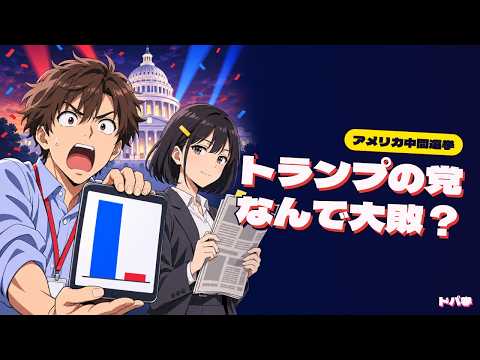 社会人部の時事解説
トランプ大統領の党、なんで大敗?
時事漫才ヨミカケ #05 の出典と事実
2026年アメリカ中間選挙で民主党が上下両院の多数派を取った件。共和党が大敗した理由(中間選挙のくせ・物価とガソリン・イランとの戦争)、二大政党制、日本との違い。動画で使った事実と出典の一覧。
 社会人部の時事解説
「来場5万人」のはずがガラガラ?
時事漫才ヨミカケ #06 の出典と事実
鳥取県倉吉市のグルメイベントで、来場想定5万人に対し来場者が大きく下回った件。「5万人」は誰の数字か、イベントの人数の見積もり方、出店者が見るべきところ、過去の似た例。動画で使った事実と出典の一覧。
- 社会人部の時事解説
1ドル160円目前、なんで円安のまま?
時事漫才ヨミカケ #07 の出典と事実
日米で15兆円あまりの円買い介入をしても、なんで円安のままなのか。円高のころと今の円安の良いこと・つらいこと、金利の差、海外の見方、これからの2つの方向。動画で使った事実と出典の一覧。
見つかりませんでした。別の言葉で探してみてください。